Stable Diffusion(ステイブルディフュージョン)は画像生成モデルの一つであり、Stability AI社、ミュンヘン大学、Runway社が共同で開発・リリースした技術です。
画像生成AIの話題が出るとよくStable Diffusionの名前も挙がってきますがStable Diffusionそのものは画像生成モデルの名称であり、企業などが出しているサービス名ではありません。
とはいえ、世に出ている画像生成サービスにStable Diffusionが組み込まれているものは多く、結果的にStable Diffusionで生成された画像…といったことは頻繁にあったりします。
評価サマリ(2026年9月時点)
| 項目 | 内容 |
|---|---|
| 無料利用 | 可能 |
| 日本語対応 | 英語推奨 (日本語対応モデルも有り) |
| 利用環境 | ローカルPC上のツール。WebUIやデスクトップアプリケーション等 |
| 商用利用 | 可能 (※) |
| アカウント登録 | 不要 (モデル入手時は配布サイトへのアカウント登録などが必要な場合有り) |
| 用途 | 画像生成 |
| 向いている人 | 生成回数のサービス上限に縛られず自分で設定・管理したい人や高性能なローカル環境を持っている人 |
| オススメ度 (5段階) | ★★★★☆ (4/5) |
※ ツールで生成した画像は原則として商用利用可能。ただし、使用する生成モデル、LoRA等のライセンス条件や第三者の著作権・商標権・肖像権の侵害有無については別途確認が必要。
運営組織について
Stable Diffusionは先述の通りStability AI社などが開発・公開してきた画像生成モデル群です。特定のWebサービスとして提供されるものとは異なりモデルの重み(≒パラメータ)や関連するソースコードなどが公開されており、各モデルのライセンス条件に従ってローカル環境での実行・改変・チューニング等が可能となっています(※)
こうした自由度の高さから、自分好みのカスタマイズを施したStable Diffusionを自身のPC上に構築する…要はローカル環境を構築するユーザーも多く存在しています。
※ 一般に「オープンソース」と紹介されることもありますが、モデルの重みとソースコードでは適用されるライセンスが異なる場合があります。利用用途などに制限があるモデルも含まれるため、すべてがOSIの定義するオープンソースソフトウェアに該当するわけではありません。
アクセス&アカウント登録方法
Stable Diffusionは先述の通りローカル環境で実行できる画像生成モデルであり、ローカルでの画像生成自体においてはサービスへのログインなどは原則不要です。
とはいえ、アカウントが不要なのはあくまでもローカル環境で利用する場合に限り、Stable Diffusionが使われている第三者のサービスを利用する場合は、そのサービスの規約に則りアカウント登録などが必要になることでしょう。
利用料金について
ローカル環境に構築する場合において、生成回数に応じたサービス利用料などは通常掛からず、基本的にはPC代と電気代を確保出来る限りにおいて生成し放題です(※)
PC代の確保がまず結構大変ではありますが……そうですねぇ、パーツ(特にGPU)の価格が上がっている現在の情勢等を鑑みると、ミドルクラスのPCを用意するとしても20~30万円は下らないんじゃないかなぁと思います。
※ SD3.5は商用利用する個人・組織の年間総売上が100万米ドルを超える場合、Enterprise Licenseが必要。
Stable Diffusionの使い方
ローカル環境への導入
使い方といっても導入する基盤や管理ツールによって様々です。とりあえずローカル環境への導入からざっくりと説明してみましょう。
①使用したいモデルの確認
Stable Diffusionにはいくつかのベースモデルがあり、各モデルによって表現できる範囲や画像サイズ(解像度)などが異なります。
基本的に新しいモデルの方が高性能ではありますが、旧モデルの方がユーザーが作成した派生チェックポイントやLoRAが充実しているため、必ずしも最新モデルを使用できることがベストとは限りません。
ということで現時点でリリースされている主流モデルの一覧と個人的な評価は以下の通りです。オススメはカスタマイズ性が高く過剰なPCスペックも必要としないSDXLですね。
| モデル | 解像度帯 | 軽さ | 画質 | プロンプト理解 | 派生モデル |
|---|---|---|---|---|---|
| SD1.5 | 512px | ★★★★★ | ★★☆☆☆ | ★★☆☆☆ | ★★★★★ |
| SD2.1 | 512~768px | ★★★★☆ | ★★★☆☆ | ★★★☆☆ | ★★☆☆☆ |
| SDXL | 1024px | ★★★☆☆ | ★★★★☆ | ★★★★☆ | ★★★★★ |
| SD3.5 Medium | 0.25~2MP | ★★★☆☆ | ★★★★☆ | ★★★★★ | ★★★☆☆ |
| SD3.5 Large | 1MP | ★★☆☆☆ | ★★★★★ | ★★★★★ | ★★★☆☆ |
②PCスペックの確認
次に自身のPCスペックで導入・動作可能な構成を調査する必要があります。
必要なリソースは多々ありますが特に重要なのはVRAM…要はグラフィックボード(GPU)の内蔵メモリですね。次点で通常のメモリ(RAM)です。ディスク容量(HDD/SSD)はあればあるだけ良いですが、継続的に使うなら最低でも1TBは積んでおくと良いでしょう。
本記事更新時点の環境目安は以下の通りです。各種軽量化を施したうえでデフォルトの解像度で画像を1枚ずつ生成すると仮定した場合に、無理なく動作するであろう最低ラインとして見てください。
| モデル | VRAMの目安 | RAMの目安 | 構成評価 |
|---|---|---|---|
| SD1.5 | 4GB | 16GB | 生成AI的にはロースペック |
| SD2.1 | 6GB | 16GB | だいぶ心許ない性能 |
| SDXL | 8GB | 32GB | ローカル環境としては及第点 |
| SD3.5 Medium | 12GB | 32GB | 新世代モデルの利用に耐えうる |
| SD3.5 Large | 16GB | 64GB | ハイスペック(だけど動画生成とかは難しい) |
ご覧のように、専用GPUを搭載していない一般的な事務用PCではロースペックにも満たないので、本格的に導入するのであればいわゆるゲーミングPCや、あるいはBTO・自作などといった方法で環境を用意する必要があります。
③管理・運用方法の確認
最後に管理ツールの選定もしておきましょう。2026年9月現在でポピュラー(だと思う)ツールの組み合わせを以下に提示してみます。
最終的には好みの問題になるかと思いますが、ご参考までに私はStability Matrix + ComfyUI(コンフィ ユーアイ)の構成を導入しています。
| 構成 | 構築難度 | 特徴 |
|---|---|---|
| ComfyUI Portable | 中 | 高機能、最新モデルへの対応が早い、詳細なワークフローを組める |
| Stability Matrix + ComfyUI | 中 | 管理が容易 |
| Stable Diffusion WebUI Forge | 低 | WebUIによる直感的な操作が可能 |
| SD.Next | 低 | WebUI有り、導入が簡単 |
| AUTOMATIC1111 WebUI | 中 | ノウハウが豊富 |
④環境構築
ここまでの内容が確認できたら実際にローカル生成環境をPC上に構築してみましょう。
構築手順の掲載は流石に長大なボリュームとなるうえ本質からも外れるので割愛しますが、Codexとかに頼めば簡単にやってくれるでしょう。なんならこの記事のURLをCodexに見せて一緒に進めてみるのも良いかもしれません。
それはそれとして管理ツールにComfyUIを選定した場合、以下のような画面が表示されるかと思います。
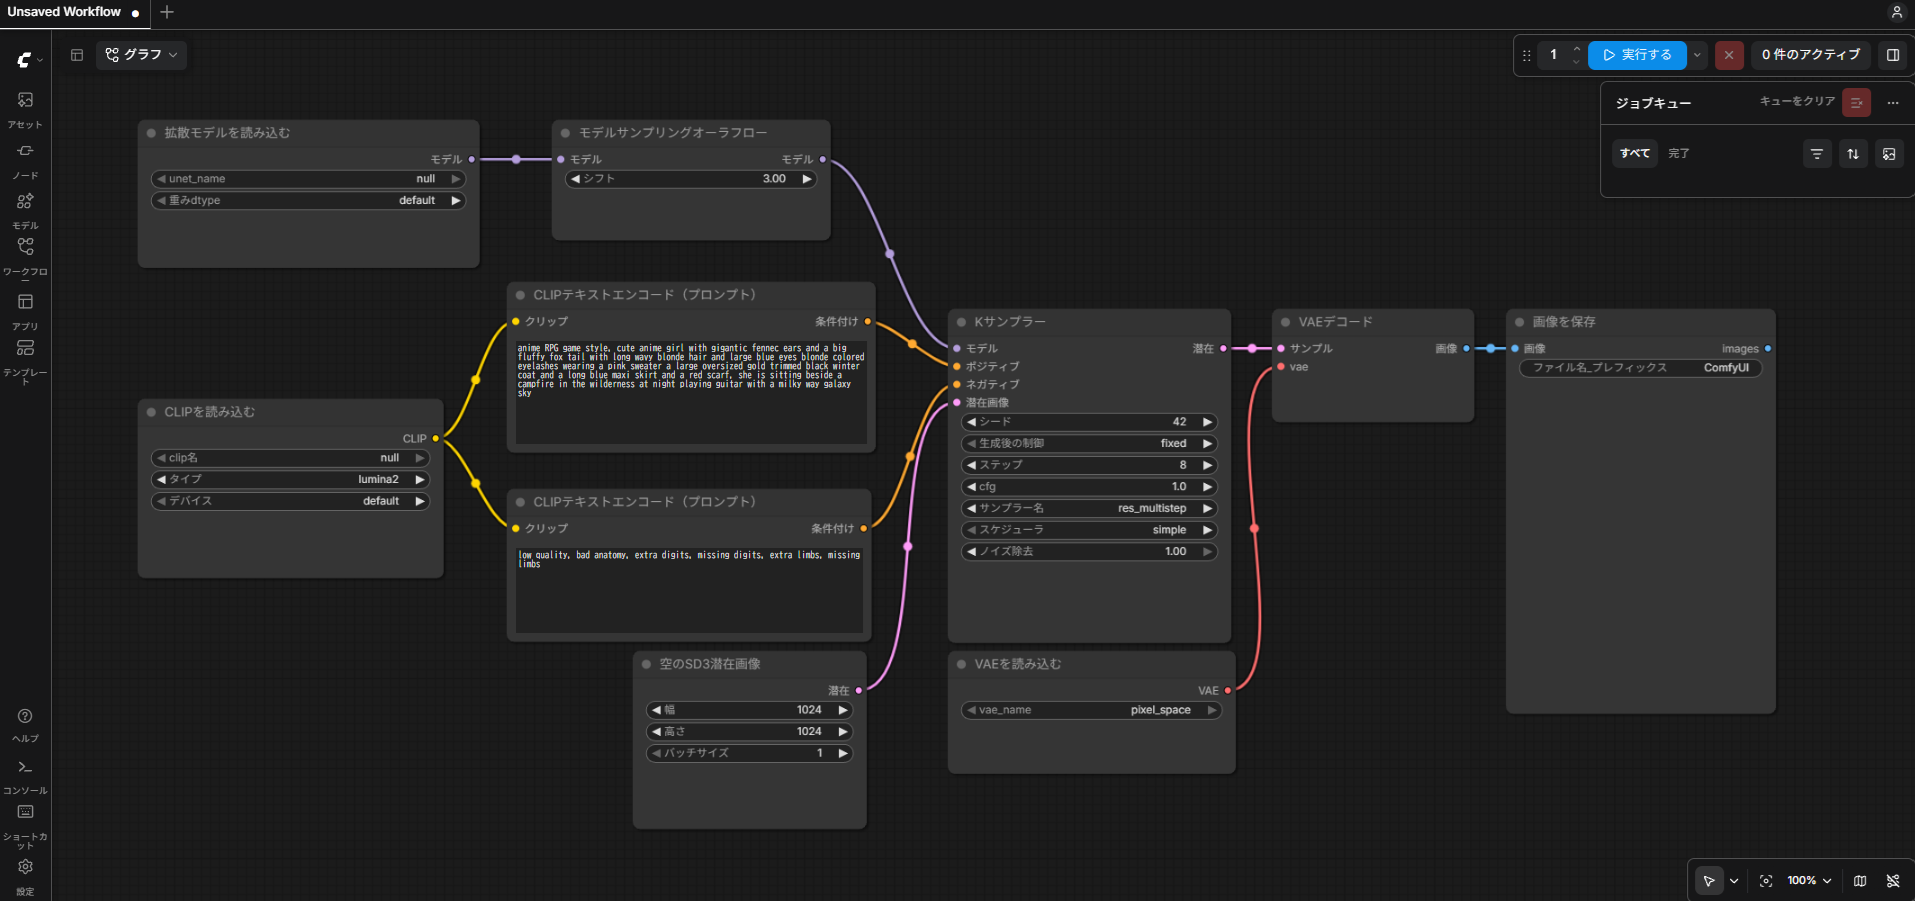
なるほどね。わかりません。
いわゆるノードベースUIと呼ばれる構成であり、データの流れが視覚的にわかりやすく拡張性も高い(とされている)デザインが特徴ですが……正直取っ付きづらいので私は管理用のUIを別に用意しました。用意したとは言ってもCodexが作ってくれたわけですが…それがコチラ。
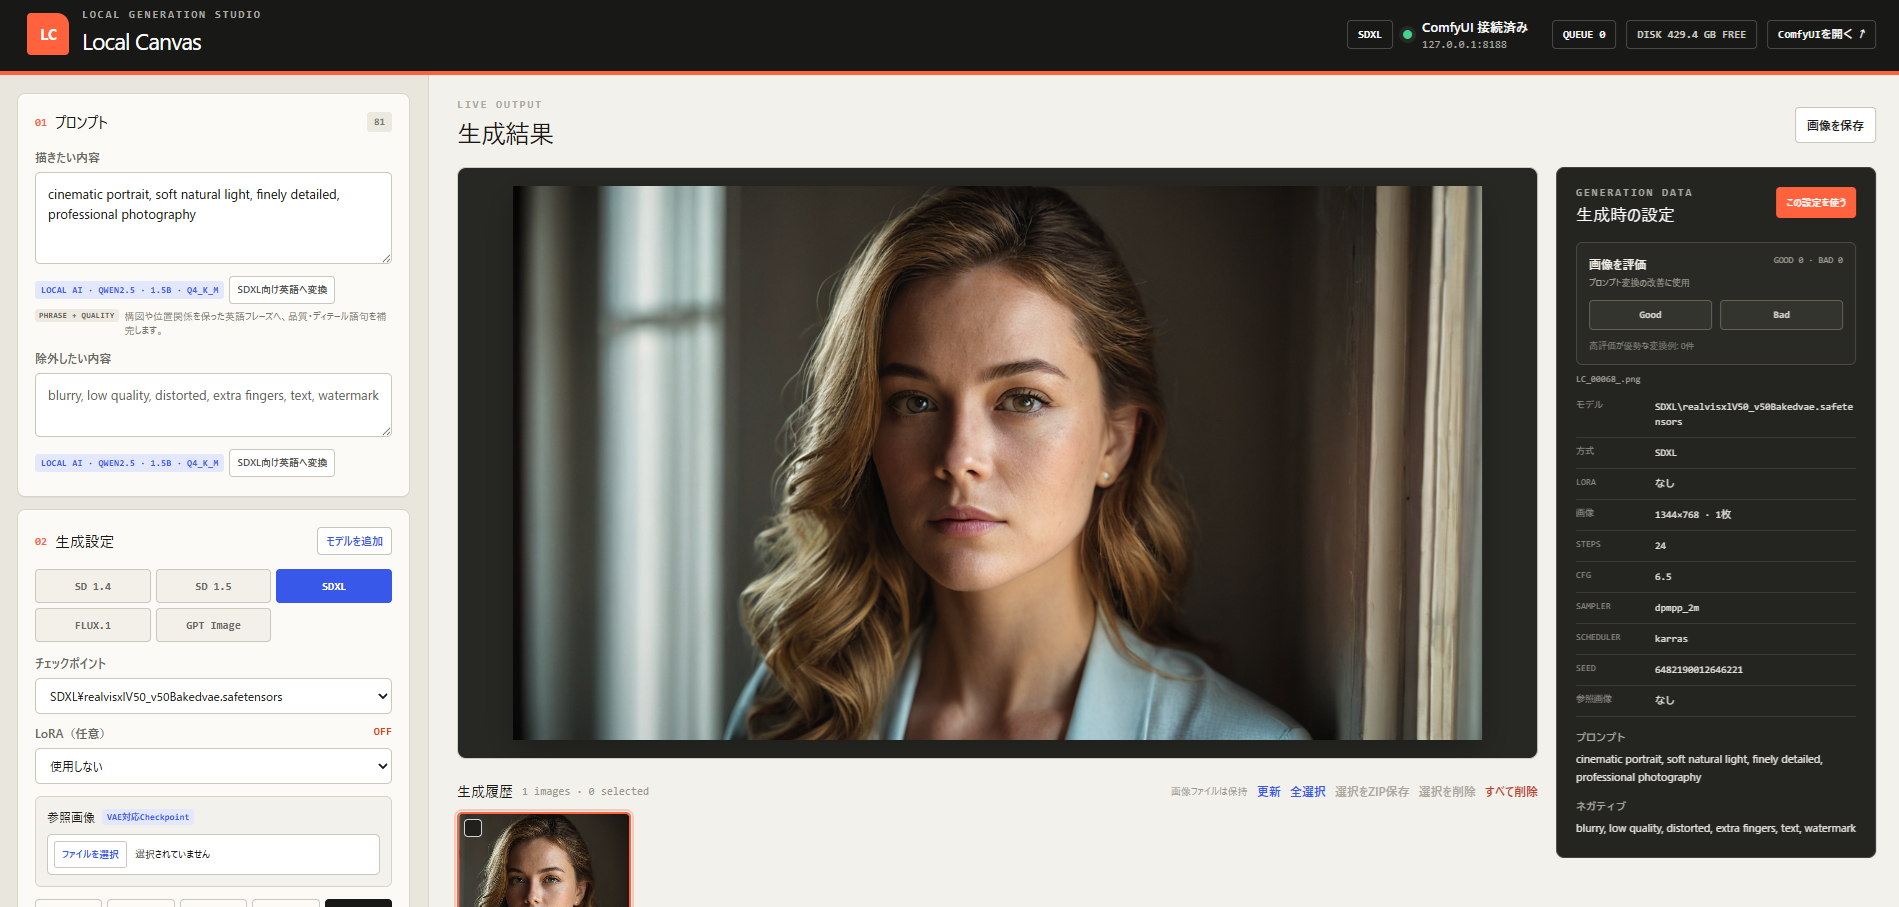
自分好みのレイアウトで使いやすい
どのような環境を構築するかは人それぞれですが、こういったアプローチもありますよ…というよりも現在はCodexなどのコーディングエージェントを利用した環境構築が手間も掛からずオススメですよ、というお話です。
まぁ、多少お金が掛かりはしますが、PC代からすれば誤差です。
テキストなどから画像を生成する
基本的にはプロンプト(画像を説明する文章)を生成モデルに入力することで、入力内容に応じた画像が生成されます。
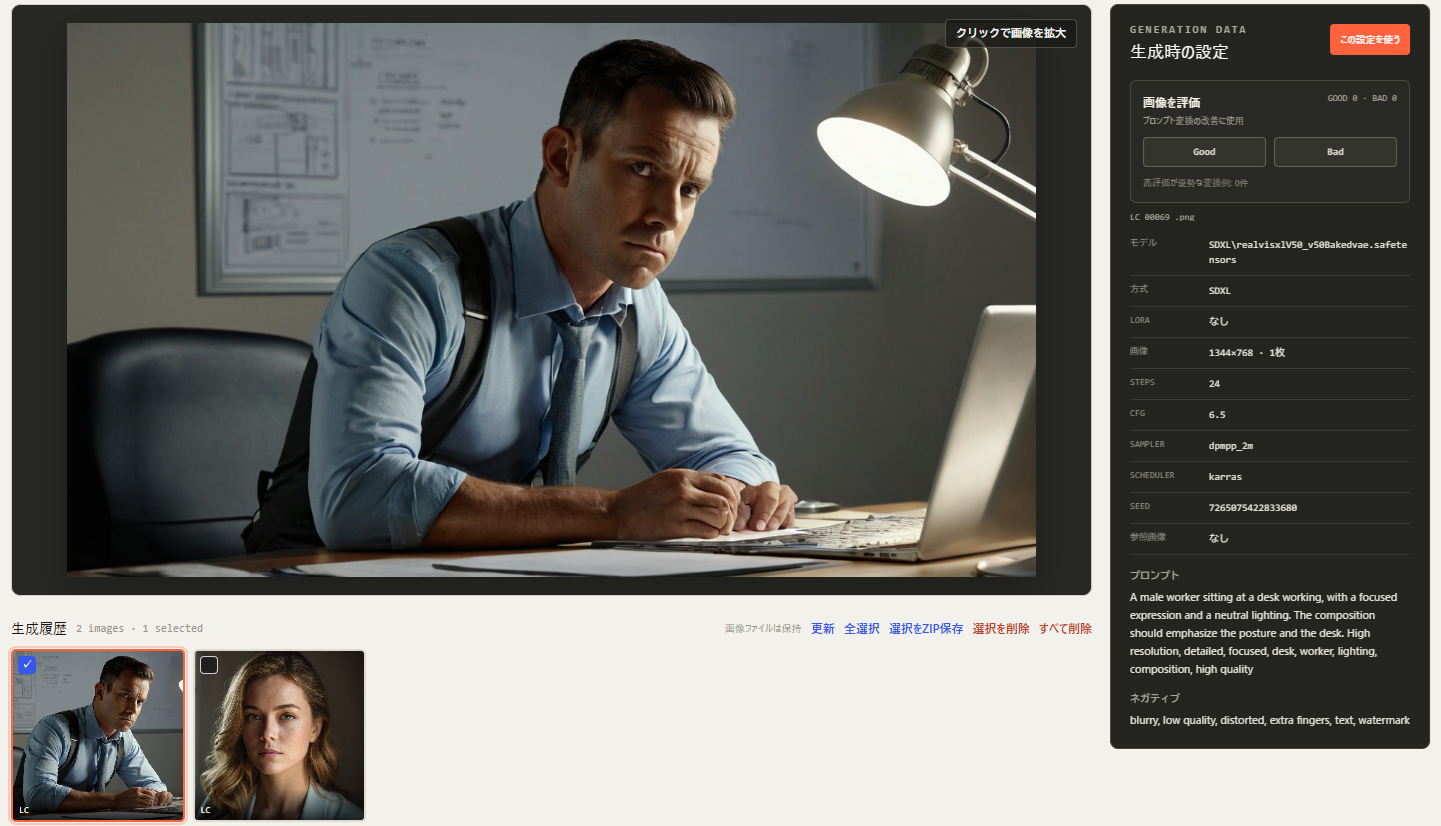
デスクで仕事をしている男性
最近のモデルでは多少融通が効くようになってはいますが、この記事で紹介しているような生成モデルの場合、プロンプトは英語で入力する方が安定します…というよりも日本語の解釈がほぼ出来ず意図しない画像ばかりが生成されがちなので英語を強く推奨します。
日本語⇔英語の変換は翻訳ツールやChatGPTなどのテキスト生成AIに手伝ってもらうと良いでしょう。
さて、プロンプト以外にもいくつか設定項目がありますのでざっくりと解説してみましょう。頻出する項目は大体以下。
| 設定項目 | 説明 |
|---|---|
| プロンプト | 生成したい画像の内容 |
| ネガティブプロンプト | 画像に含めたくない内容 |
| チェックポイント | 画像生成の基礎となるモデル |
| LoRA | キャラクターや画風などを追加する補助モデル |
| Steps | 画像生成処理の反復回数 |
| CFG | プロンプトへの追従度 |
| Sampler | ノイズを除去する計算方法 |
| Scheduler | ノイズを除去する進行方法 |
| Seed | 初期ノイズを決める乱数値 |
ノイズがどうと言われてもよくわからないし難しい話ですね。というわけで図解です。
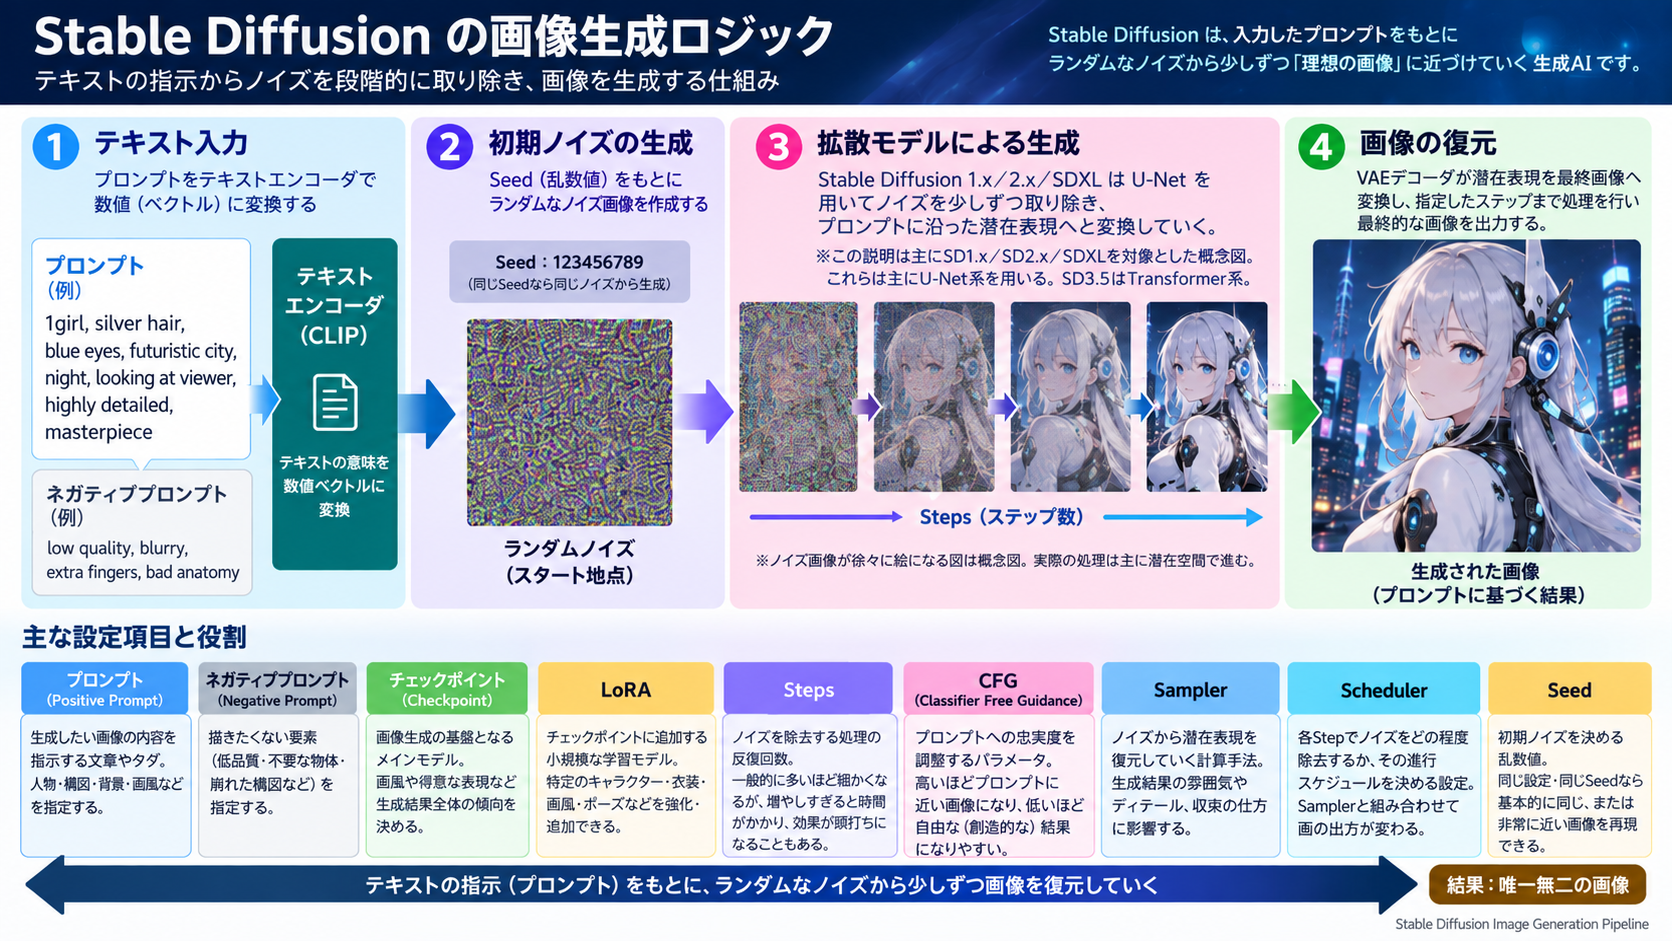
わかりやすい…?
それぞれが大事な要素であり、この設定にしておけばOK!みたいなものは無いので、試行錯誤をしながら自分なりの設定を見付けていくこととなります。これがノウハウってやつですね。
それでは最後にいくつかサンプル的な画像を生成して終わりとしましょう。プロンプトは図解の内容を使用し、チェックポイントは現時点で入手可能なもの、LoRAは未使用とします。
コピペ用プロンプト
1girl, silver hair, blue eyes, futuristic city, night, looking at viewer, highly detailed, masterpieceネガティブ
low quality, blurry, extra fingers, bad anatomy
一応念のためですが画像の品質はチェックポイントの性能に大きく依存します。特にSD1.4とSD1.5の公式ベースモデルはちょっとあまりにも…だったのでそこから追加学習等が施された派生モデルを使用しています。
SD1.4
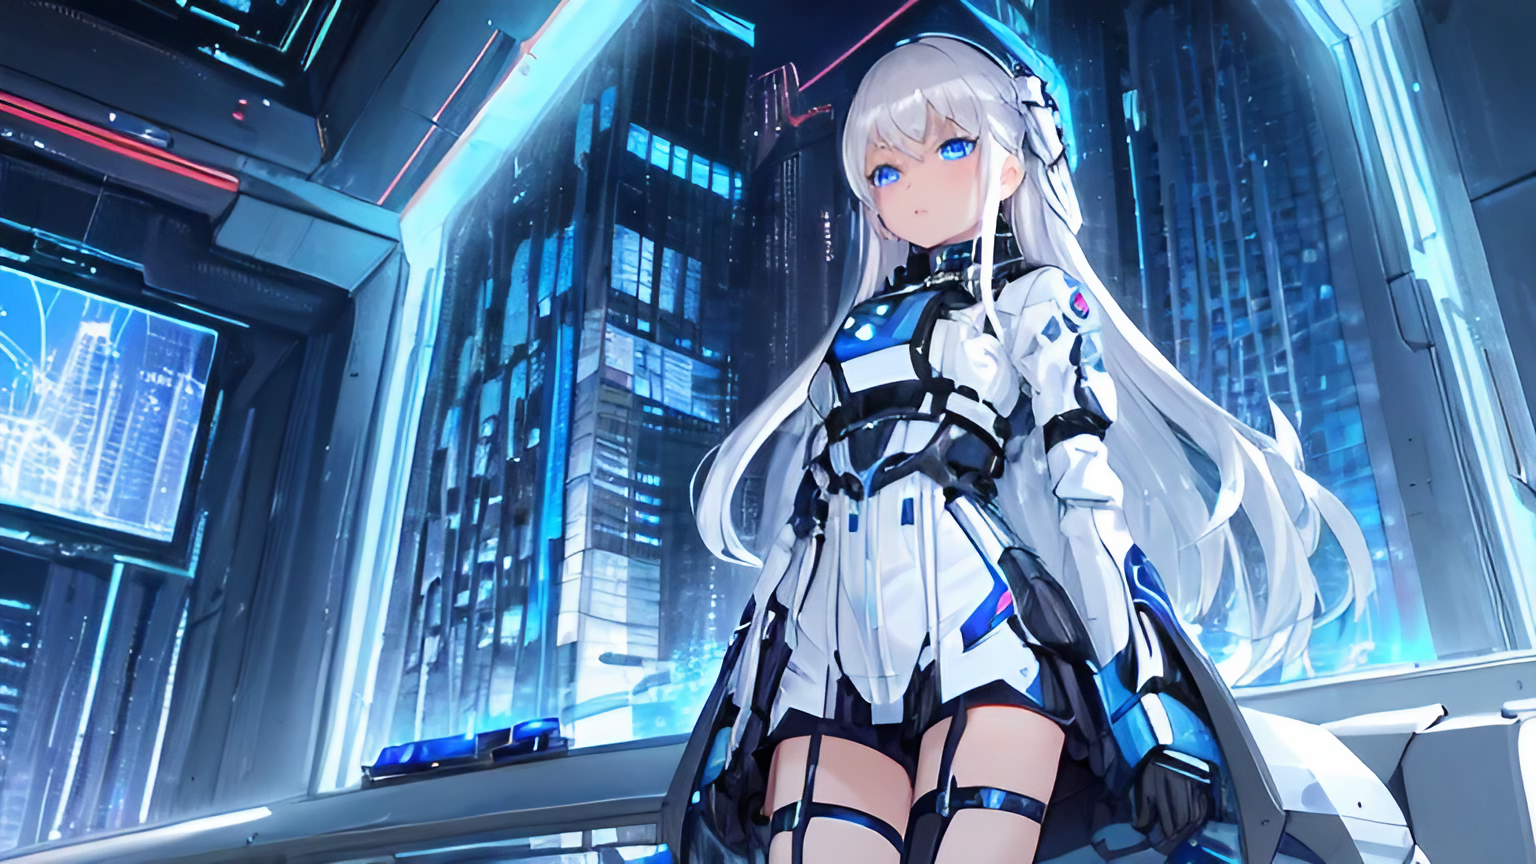
今となってはレガシーなモデル
| 設定内容 | 設定値 |
|---|---|
| チェックポイント | storeBoughtGyozaMix_v10.safetensors |
| Steps | 24 |
| CFG | 7 |
| Sampler | dpmpp_2m |
| Scheduler | karras |
| Seed | 2711840836300421 |
SD1.5
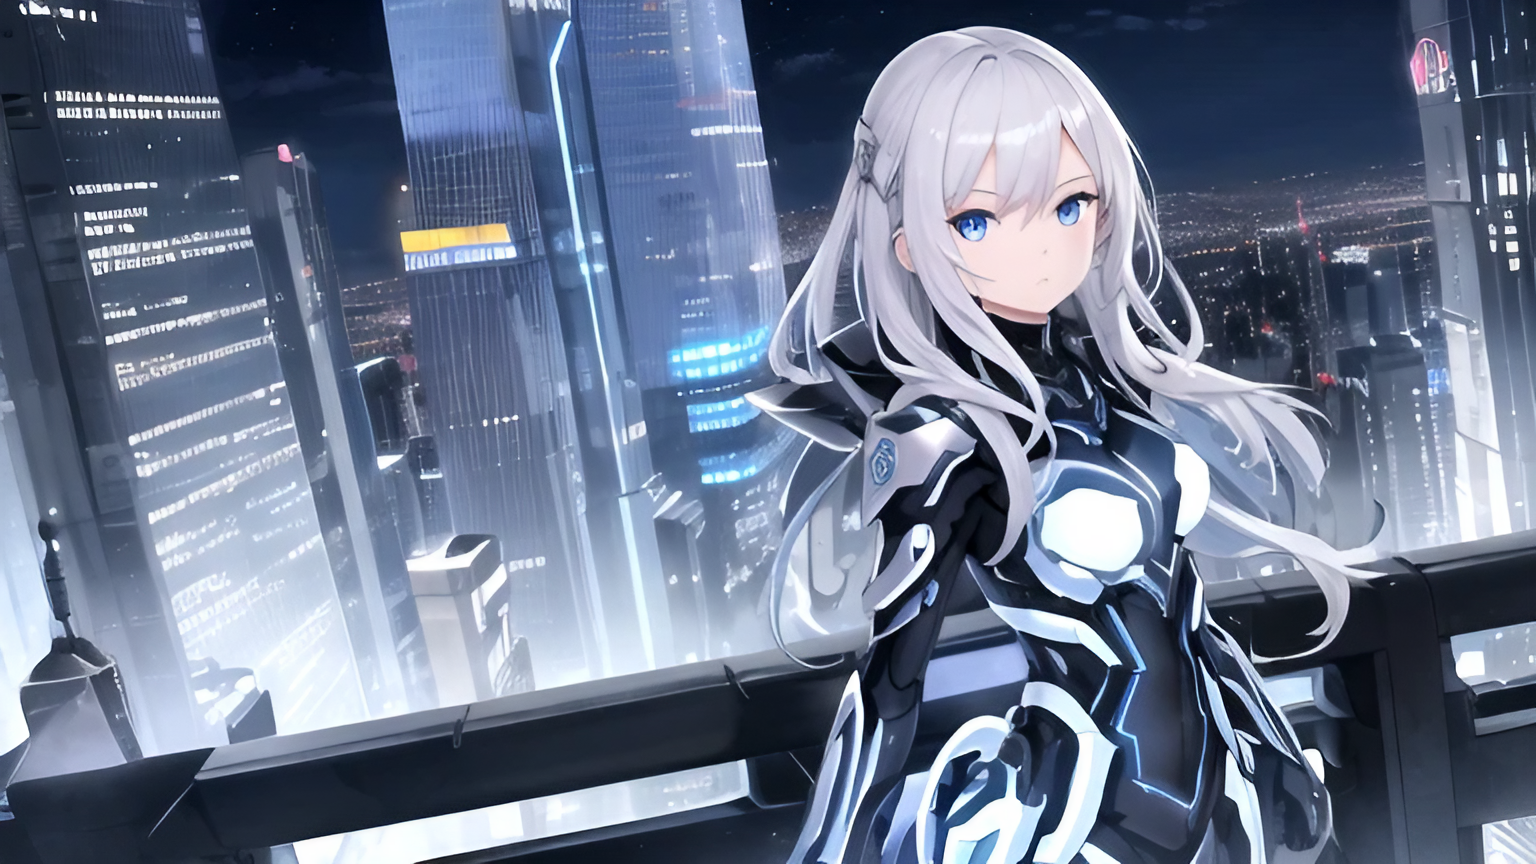
SD1.4程では無いですがレガシーです
| 設定内容 | 設定値 |
|---|---|
| チェックポイント | anyloraCheckpoint_bakedvaeBlessedFp16.safetensors |
| Steps | 24 |
| CFG | 7 |
| Sampler | dpmpp_2m |
| Scheduler | karras |
| Seed | 3644707148777723 |
SDXL
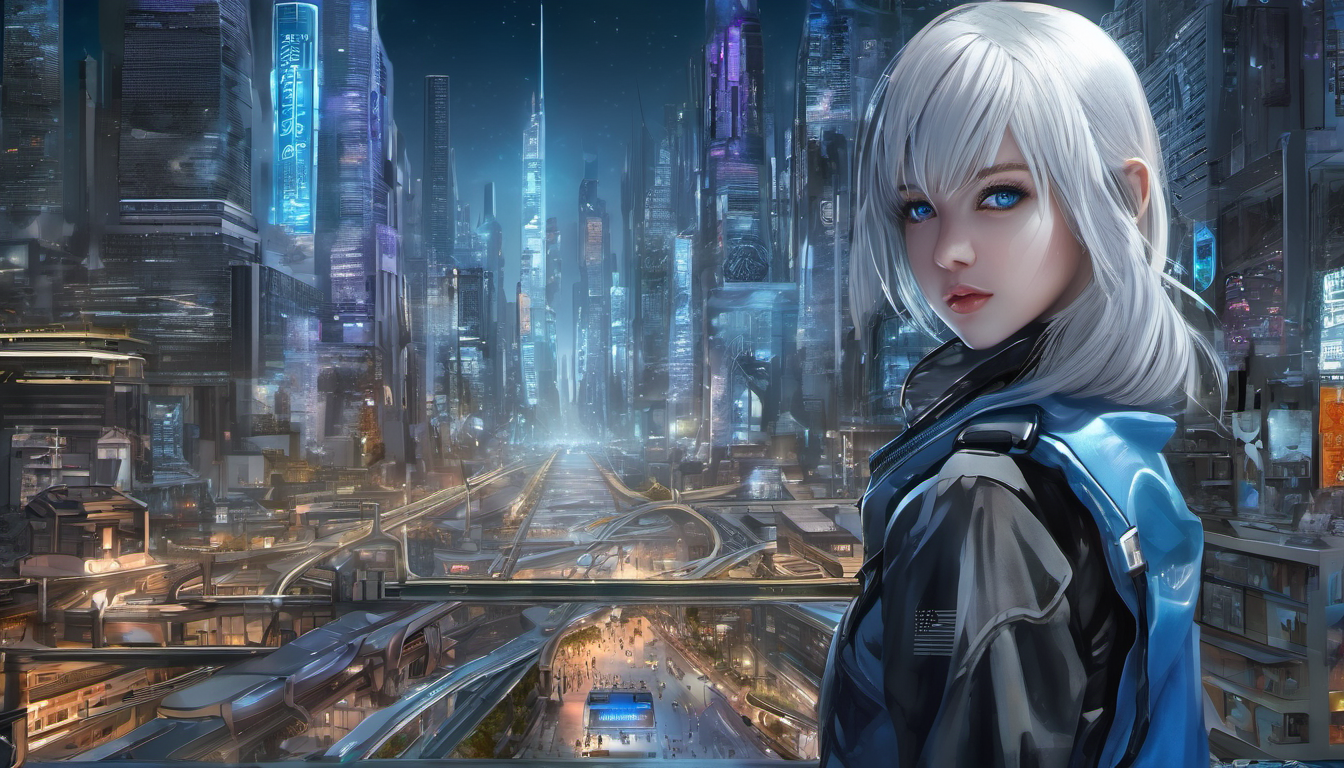
まだまだ主流のモデルです
| 設定内容 | 設定値 |
|---|---|
| チェックポイント | sd_xl_base_1.0.safetensors (公式ベースモデル) |
| Steps | 24 |
| CFG | 6.5 |
| Sampler | dpmpp_2m |
| Scheduler | karras |
| Seed | 8535058670801331 |
(参考)FLUX.1
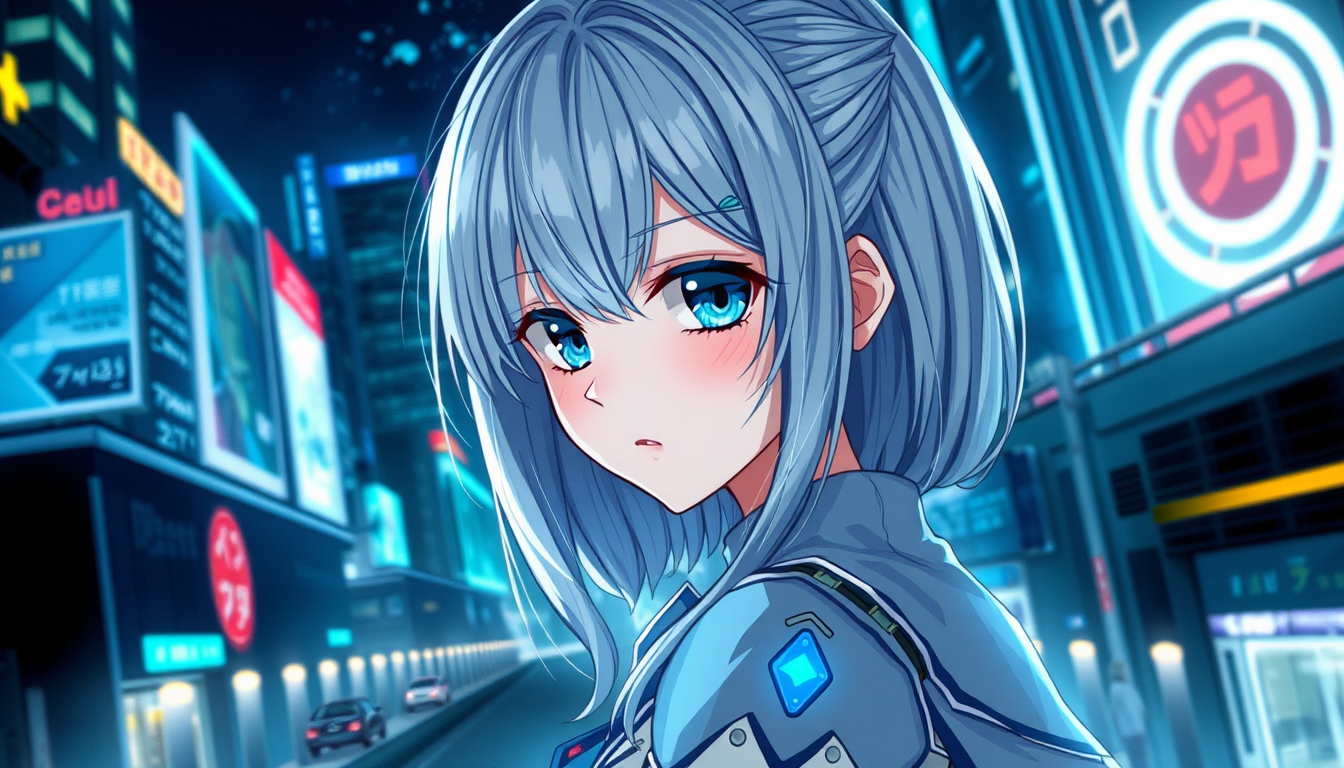
テキストの描写などが得意なモデルです
| 設定内容 | 設定値 |
|---|---|
| チェックポイント | flux1-schnell-fp8.safetensors |
| Steps | 4 |
| Sampler | euler |
| Scheduler | simple |
| Seed | 5903243404485386 |
ネガティブプロンプトの概念が無く、生成方式もSDとは異なることから設定内容に違いが出ています。
(参考)GPT-Image-2
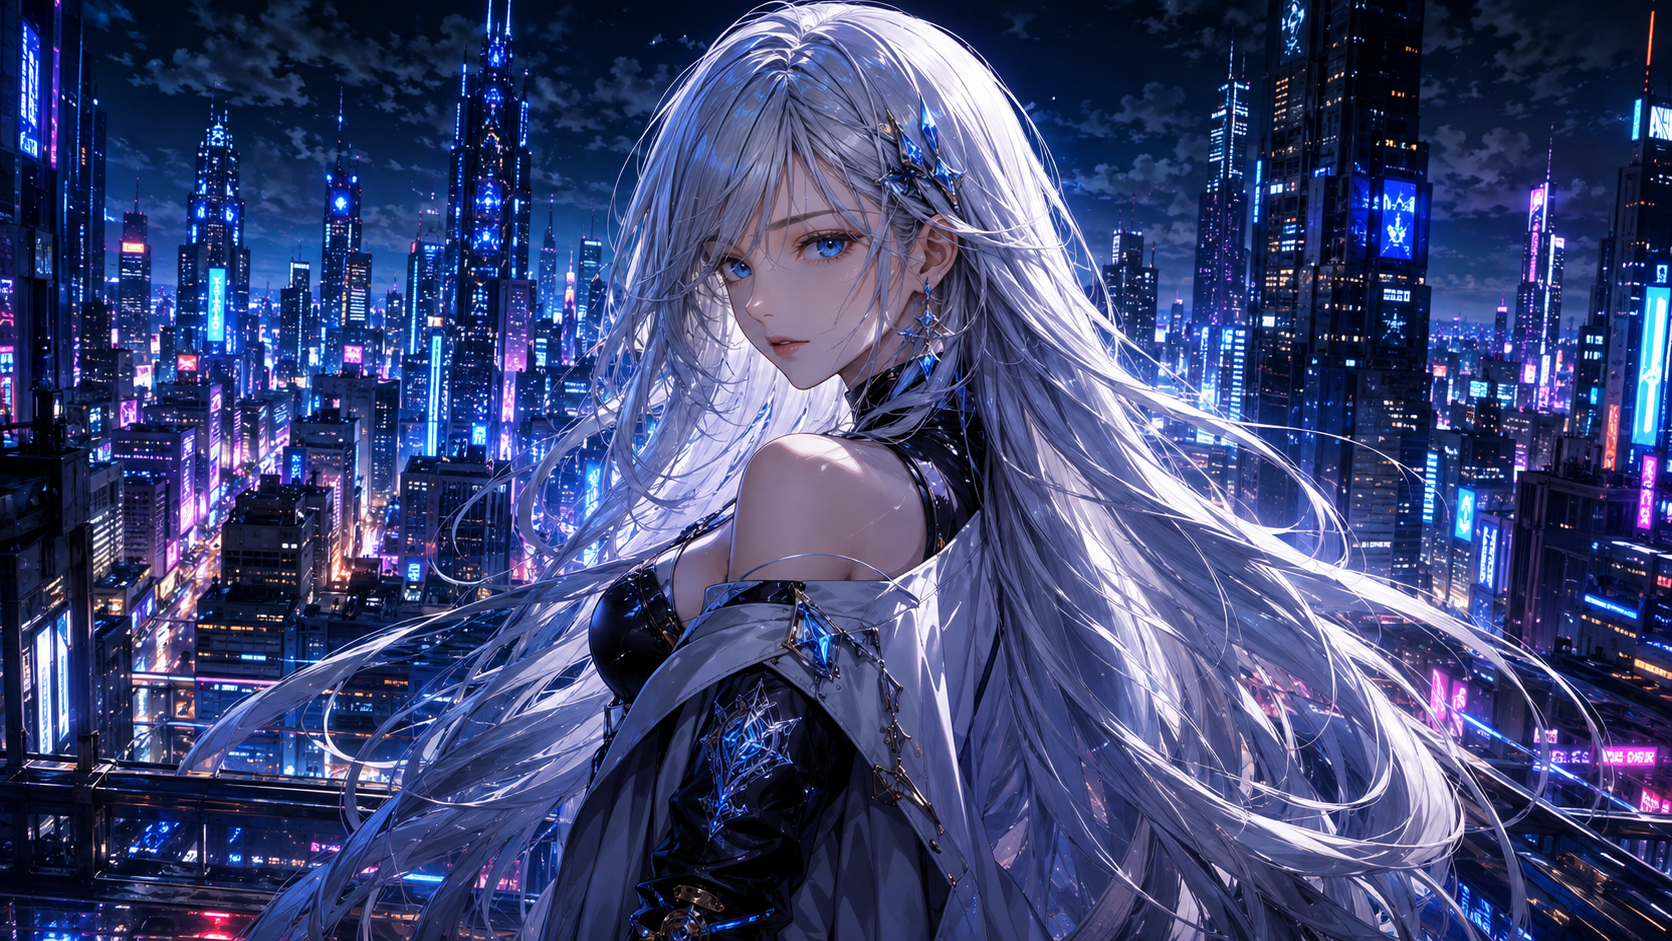
もはやSDでもなんでもないですが…
チェックポイント等といった概念が無い…というよりも一般には非公開の情報となっています。参考になるかはわかりませんが、現時点で最新の画像生成モデルということで。
使用した感想
各種モデルの良し悪しについては割愛します。こういった技術が世に出たこと自体が凄いことなのであって、Stable DiffusionはAIによる画像生成に関して一種のブレイクスルーを果たしたと言えるでしょう。
2026年現在ではPCのスペックさえ確保できれば構築自体はコーディングエージェント等を用いて自動化できるため、導入の負担が下がった分だけ参入敷居も下がった印象です。
理想的な画像の生成にはノウハウの蓄積が必須ではありますが、それも生成AIに聞けばある程度は教えてくれるかも知れません。
(補足)リンク集
リンク先の安全性は自分の目で確認をお願いします。
管理ツール
| ツール名 | リンク | 補足 |
|---|---|---|
| ComfyUI Portable | 公式配布・導入ガイド | Windows向け。GPUに合ったパッケージを選択可能 |
| Stability Matrix | 公式リリースページ | – |
| Stable Diffusion WebUI Forge | 公式GitHub | 配布・導入手順を掲載 |
| SD.Next | 公式GitHub | Windows向けの公式インストーラーもあり |
| AUTOMATIC1111 WebUI | 公式GitHub | 配布・導入手順を掲載 |
ベースモデル
| モデル | リンク | 補足 |
|---|---|---|
| SD1.4 | モデル配布ページ | CompVisによる配布 |
| SD1.5 | モデル配布ページ〈ミラー〉 | 旧Runway配布のミラー。非公式 |
| SD2.1 | 現行の公式配布先は確認できず | 参考:Diffusers公式ドキュメント |
| SDXL | 公式モデル配布ページ | Stability AIによる配布 |
| SD3.5 Medium | 公式モデル配布ページ | ダウンロード時にログイン・利用条件への同意が必要 |
| SD3.5 Large | 公式モデル配布ページ | 同上 |
| FLUX.1 schnell | 公式モデル配布ページ | 開発元Black Forest Labsによる配布 |
生成サンプルで使用しているチェックポイント
| ファイル名 | 掲載用リンク | 補足 |
|---|---|---|
| sd_xl_base_1.0.safetensors | 公式ファイルページ | – |
| flux1-schnell-fp8.safetensors | Comfy-Org配布のファイルページ | ComfyUI向けのFP8変換・再パッケージ版 |
| storeBoughtGyozaMix_v10.safetensors | 作者Jemniteの配布ページ | – |
| anyloraCheckpoint_bakedvaeBlessedFp16.safetensors | AnyLoRAの元配布先〈Civitai〉 | – |